新闻中心
热销推荐
SONY FCB-ER9500主要性能特点: 传感器:1/1.8英寸型S...
Sony FCB-EV9520L高清机芯模组主要特点: 传感器:1/2...

SONY FCB-EW9500H主要功能特点: 传感器:1/1.8英寸型...
传感器:1/1.8英寸型STARVIS CMOS 视频输出:全高清(10...
时间:2026-11-03 15:44:51 来源: 深圳市轩展科技有限公司 浏览数: 5
可见光摄像头端到端延迟不是某个模块的耗时,而是"处理时间 + 排队时间 + 同步等待"的累加;每经过一个"为了稳定先缓存一下"的环节,画面就旧一帧。
帧率稳定、CPU不高、画面流畅,都不能证明你看到的是"现在的画面"。
很多人遇到这种情况,第一反应都是“算法跑太慢”“摄像头帧率不够”,但实际上,端到端延迟可能藏在整条传输链路的任意一个环节里,从Sensor采集画面、编码板转换到最终屏幕显示,每多排一次队,就可能多等一帧的时间。
可见光摄像头端到端延迟全景:从 Sensor、编码板到屏幕,延迟到底藏在哪?
这三个概念经常被混为一谈,很多开发者做了很久视觉项目,还是没理清三者的本质区别:
帧率:一秒钟能产生或处理多少帧画面
吞吐量:系统单位时间内能完成的总工作量
延迟:某一帧画面从现场真实发生,到最终结果输出被人或设备感知的总耗时
流水线完全可以做到30fps稳定输出,同时端到端延迟高达500ms。它每33ms就能处理完一帧,吞吐量完全达标,但队列里一直压着15帧缓存,你看到的永远是半秒前的画面。这就像一家高效率的面馆,后厨每分钟能稳定出30碗面,可取餐台已经排了15碗,你拿到手的面永远是半分钟前煮好的——出餐率不低,面也没丢,就是不够新鲜。
|一句话总结:高帧率决定画面更新频率,低延迟决定画面新鲜程度。
一帧画面的端到端总延迟,从来不是某一个模块的单独耗时,而是沿途处理时间、排队时间、同步等待时间的总和。整条链路里,几乎每一个环节都可能偷偷“攒”出延迟。
1. 图像传感器本身就自带延迟
Sensor是把光线转换成数字像素的核心芯片,它的延迟来自三个容易被忽略的细节:
曝光时间:Sensor需要在一段时间内收集光线才能完成成像,白天强光下曝光可能只有几毫秒,暗光环境下自动曝光会被拉长,曝光时间越长,这一帧完成成像的时间就越晚,还可能伴随运动模糊。很多场景里环境一暗,系统延迟突然飙升,别先查代码,先看实际曝光时间和自动曝光策略。[1]
帧周期:30fps的一帧周期约33.3ms,60fps约16.7ms,这不代表30fps必然有33ms延迟,但任何需要“等下一帧”“完整缓存一帧”的环节,都会按这个时间单位产生额外等待。
卷帘曝光:绝大多数可见光摄像头采用的是卷帘曝光方式,不是整幅画面同时读出,而是一行行扫描输出,画面顶部和底部并非同一瞬间采集,高速运动场景下还会出现倾斜、果冻效应。很多开发者只看“应用收到帧的时间”,却忽略了摄像头时间戳到底代表曝光开始、曝光结束,还是缓存写完的时刻,直接漏掉了前面的全部等待时长。
2. ISP与编码板:画质优化的隐形代价
ISP负责把Sensor输出的原始裸数据加工成正常可见的画面,里面的去马赛克、降噪、色彩校正、缩放流程,部分可以流水执行,但很多高级算法需要行缓存、帧缓存,甚至参考前后帧的信息。比如时域降噪,借助多帧信息能大幅提升画面干净度,但算法天然不可能做到“既要看前后帧,又完全不等前后帧”,多帧参考的过程就会直接引入额外延迟。
索尼FCB-EV9520L,当打开低延迟模式时,数字变焦、图像防抖、宽动态、3D降噪等功能不可用,就是为了不引入额外的延迟。
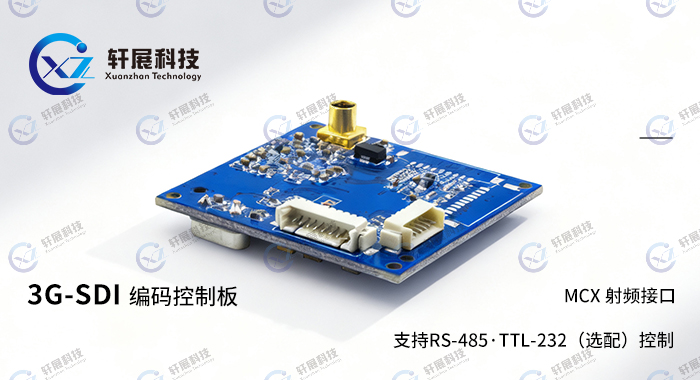
而我们常用的12G/6G/3G-SDI编码控制板、4K/HD-HDMI编码控制板,恰恰是延迟最容易被低估的环节。SDI信号本身传输几乎无延迟,但编码器需要先完成SDI信号解码、格式转换,整个过程会经过输入FIFO缓存、帧内/帧间预测计算、码率控制队列、网络发送缓冲多级缓存,为了保障编码质量启用B帧参考、GOP结构优化时,端到端延迟很容易从几十ms飙升到百ms。HDMI编码控制板也存在类似问题,很多方案默认开启自适应缓冲保障传输稳定,却没意识到这会让实时场景的延迟直接翻倍。
|核心取舍原则:画质、码率稳定性、压缩效率、低延迟无法同时拉满,需要固件层面做取舍。
3. 图像缓冲区排队:最隐蔽的延迟来源
Linux系统里的V4L2接口,为了保障采集稳定性,会准备多块Buffer循环使用,避免CPU偶尔卡顿就导致摄像头无处写入数据。但如果应用处理速度跟不上采集速度,队列就会开始积压旧帧。
此时应用仍然每次都能正常拿到一帧画面,看起来完全没有卡死,只是你拿到的永远不是最新帧。深队列不一定会掉帧,却会让整个系统一直追着旧帧跑——实时控制场景里,宁愿丢掉过期帧换取最新画面,也不要一队列的“新鲜历史影像”。
当然Buffer也不是越少越好:Buffer太少,应用稍微卡顿一下,设备就会没有空的写入位置,直接导致丢帧、吞吐下降;Buffer太多,只要消费速度变慢,就会快速积累延迟。本质上是不同场景的取舍:录像场景更怕丢帧,可以接受适度排队;视觉控制场景更怕画面过期,宁愿丢帧也要优先取最新帧。
4. 多媒体框架里的隐形队列
一帧画面离开V4L2驱动,不代表它就彻底摆脱排队了。GStreamer这类多媒体框架里,queue元素为了让不同线程独立工作,会暂存数据;appsink作为把图像交给应用的出口,内部也会排队等待应用取走画面。如果应用消费速度太慢,队列长度会持续增长,要么阻塞上游采集,要么按配置丢弃数据。
大家常用的OpenCV VideoCapture接口,底层可能通过V4L2、GStreamer、FFmpeg等多个后端工作,你在应用层只看到一次read()操作,底下究竟叠了几层Buffer,很多时候根本无法一眼看清。典型的延迟路径里,V4L2、GStreamer、appsink、算法、显示各自缓存一帧,各个部门都想着“先缓存一下保障稳定”,最后系统确实很稳定,稳定地输出半秒前的画面。
5. 格式转换、内存拷贝与显示端的额外等待
如果一帧画面的数据流是NV12→BGR→RGB→NPU输入→结果叠加→NV12,相当于在内存里连续换了四五套“工装”,分辨率越高,搬运和格式转换的耗时就越明显。这类耗时不一定立刻造成队列积压,但一旦处理时间超过帧周期,队列就会接手,把延迟持续放大。
很多开发者优化完前面所有环节,最后却栽在显示端。画面处理完成后,不会立刻出现在屏幕上:图像要先上传到GPU或显示Buffer,经过合成器排队,再经过双缓冲/三缓冲等待下一次垂直同步VSync,最后由显示面板逐行刷新完成输出。很多人只量算法函数入口和出口的时间戳,觉得算法20ms就跑完了,实际从挥手到屏幕看到变化,显示端就吃掉了上百ms的等待时间。
|端到端延迟测量,必须从真实事件发生时刻,测量到画面肉眼可见,或是控制信号输出生效,不能局限于算法内部时间戳。
可见光摄像头的端到端延迟,从来不是单一模块的问题:Sensor曝光和逐行读出、ISP多帧图像处理、SDI/HDMI编码控制板的多级缓冲、全链路各层队列、格式转换与内存拷贝、算法处理和屏幕刷新,每一个环节都可能成为延迟的来源。
大多数可见光摄像头延迟,本质上都藏在“为了稳定先缓存一下”的思路里——每层多等一帧,最后你看到的,就会是一个画面很流畅、内容却已经过时的世界。
当你看到这里,你还会继续追问可见光摄像头或者编码控制板的延时是多少吗?延迟会藏在每一个环节里。
问:帧率很高、画面很流畅,为什么还是觉得"慢半拍"?
答:因为流畅描述的是帧间隔稳定,延迟描述的是帧的年龄。队列里压着十几帧时,两者可以同时成立。
问:显示端怎么优化延迟?
答:可以选择高处理能力的显示设备。
[1]
帧率和曝光时间到底啥关系?
https://blog.csdn.net/chenai886/article/details/151179424
下一期我们继续为大家分享可见光摄像头延迟相关内容:
可见光摄像头延迟:怎么测量与优化?如何场景化落地?
上一篇:常被用于4K手术摄像机,索尼FCB-CR8530的色彩还原到底怎么样?
下一篇:暂无

周一至周五(8:30 - 18:00)节假日休息